
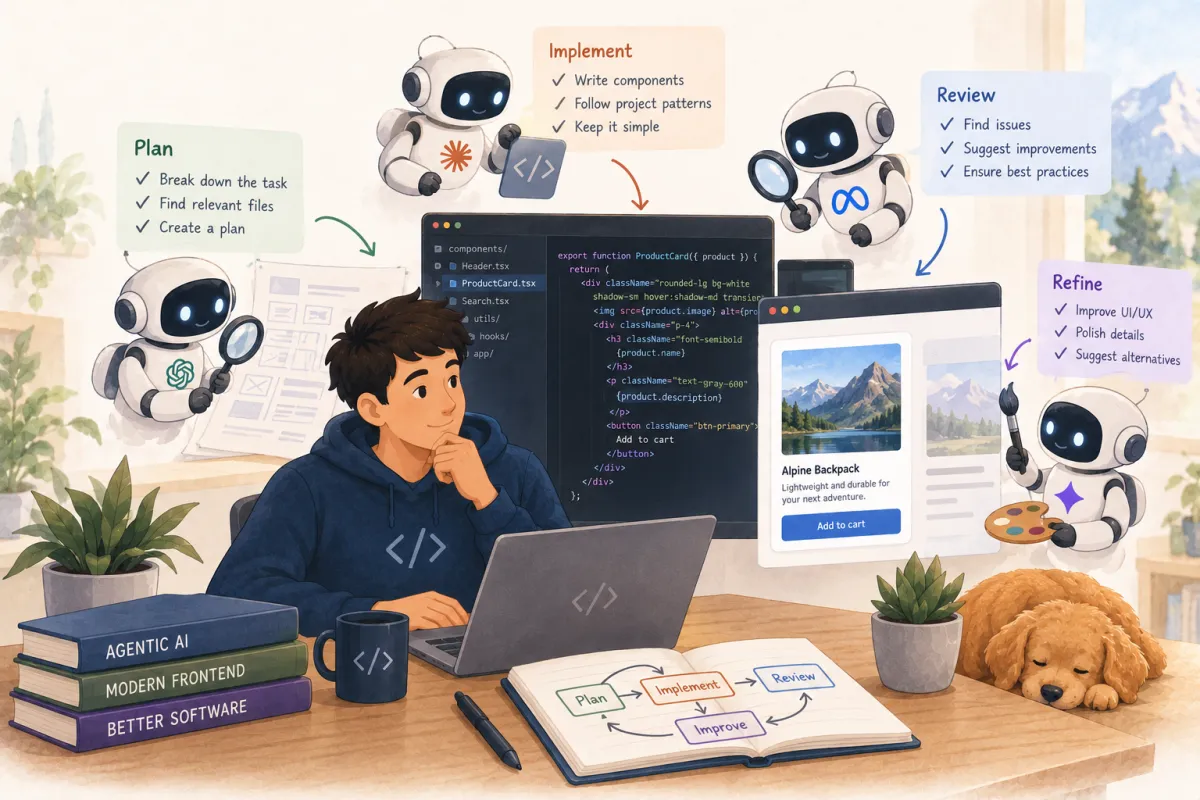
Cet article est différent de mes écrits habituels. Je ne vais pas vous guider à travers quelque chose que j'ai livré. À la place, je veux explorer ce qui se passe réellement avec l'IA agentique dans le développement frontend en ce moment — quels outils existent, ce que les équipes font avec, et où je pense que les vraies opportunités se trouvent. Considérez ceci comme un rapport d'éclaireur.
Mon point de départ était simple : j'ai connecté Claude Code à un serveur Figma MCP. Cette seule connexion — un agent de code IA qui pouvait voir mes fichiers de design — a changé ma façon de penser tout le workflow frontend. Cela m'a fait me demander : quoi d'autre les agents peuvent-ils voir ? Quoi d'autre peuvent-ils faire ? Alors j'ai creusé.
La couche MCP : donner des yeux et des mains aux agents
MCP — Model Context Protocol — est la pièce qui transforme un assistant de code en quelque chose de plus proche d'un développeur. Sans lui, votre IA peut écrire du code, mais elle est aveugle. Elle ne peut pas voir vos designs, votre bibliothèque de composants, votre sortie navigateur ou vos résultats de tests. Avec les bons serveurs MCP connectés, elle peut voir tout cela.
Le serveur Figma MCP a été mon point d'entrée. Il donne à l'agent un accès direct aux données de design — variables, composants, mise en page, et même une représentation de code React + Tailwind. Vous sélectionnez un frame dans Figma, le serveur MCP extrait les tokens de design et la mise en page, et l'agent génère des composants à partir d'un vrai contexte de design au lieu de deviner depuis une capture d'écran. Ça remplace l'ancien workflow de copier-depuis-l'inspecteur. Le résultat n'est pas du code de production — c'est de l'échafaudage — mais de l'échafaudage qui utilise déjà vos vrais tokens de design et espacements.
Mais Figma MCP n'est qu'une pièce. L'écosystème qui se forme est plus intéressant que n'importe quel serveur individuel. Storybook a livré un serveur MCP dans sa version 10.3 qui permet aux agents de consulter vos composants existants, leurs props et leurs stories avant d'écrire du nouveau code. Google a lancé Chrome DevTools MCP — les agents peuvent maintenant inspecter le DOM, analyser les requêtes réseau, lire les erreurs console et prendre des captures d'écran de l'app en cours. Le Playwright MCP de Microsoft expose l'automatisation navigateur pour les tests E2E. Et Context7 fournit aux agents la documentation framework à jour, évitant l'erreur fréquente où un agent mélange des patterns de Next.js 13 et 15.
Le stack pratique qui émerge : Figma MCP pour le design, Storybook MCP pour votre bibliothèque de composants, Chrome DevTools MCP pour le débogage, Playwright MCP pour les tests, Context7 pour la doc framework. Connectez les cinq et votre agent passe d'un assistant d'écriture de code à quelque chose qui peut voir le design, vérifier ce qui existe déjà, générer du code, le vérifier dans le navigateur et écrire des tests. Ce n'est pas un jouet. C'est un workflow.
Des revues de PR qui comprennent le contexte
La revue de PR automatisée est l'un des cas d'usage agentiques les plus matures en frontend. Les outils ont dépassé le stade du « linter glorifié ». CodeRabbit a revu plus de 13 millions de PRs sur 2 millions de repos — il exécute plus de 40 linters intégrés et génère des suggestions contextuelles pour TypeScript, React et le reste de votre stack. Greptile adopte une approche différente : il construit d'abord un graphe de connaissances de votre codebase, puis revoit avec un contexte architectural. Il trouve plus de bugs mais génère plus de faux positifs — le classique compromis précision-rappel.
Ce que ces outils trouvent réellement pour les équipes frontend : la gestion d'erreurs manquante, les imports inutilisés, les incohérences de types et les anti-patterns React évidents comme les tableaux de dépendances manquants dans les hooks useEffect. Ce qu'ils ne trouvent pas de manière fiable : les problèmes de performance de rendu, les stratégies de mémoïsation incorrectes ou les bugs subtils de gestion d'état. Les jugements — si ce composant devrait être découpé, si cette abstraction est prématurée, si ce flux de données va confondre le prochain développeur — ont encore besoin d'un humain.
Mais voici ce qui m'enthousiasme : ces outils deviennent meilleurs pour comprendre les conventions de votre projet, pas seulement les bonnes pratiques génériques. Quand votre reviewer IA connaît votre codebase — votre structure de dossiers, vos patterns de nommage, vos limites de composants — il peut imposer une cohérence à un niveau difficile à atteindre pour un reviewer humain sur des dizaines de PRs par semaine.
Au-delà d'ESLint : imposer l'architecture avec des agents
C'est le domaine que je trouve le plus intéressant pour les ingénieurs seniors et les tech leads. Le linting traditionnel trouve les problèmes de syntaxe et de formatage. L'application architecturale — « pas de logique métier dans les composants », « chaque appel API passe par la couche service », « l'état partagé doit utiliser ce pattern spécifique » — a toujours reposé sur la revue de code et le savoir tribal. Cela change.
Le pattern qui émerge : vous définissez des contraintes dans des fichiers lisibles par machine (CLAUDE.md, AGENTS.md, Architecture Decision Records), l'agent écrit du code en suivant ces règles, et des vérifications CI déterministes bloquent les violations. L'agent corrige ensuite ses propres violations sans intervention du développeur. Un outil appelé Archgate transforme les ADR en fichiers de règles exécutables qui tournent en CI — un check qui échoue bloque les merges. L'agent consulte les règles avant d'écrire du code, donc la plupart des violations n'arrivent jamais dans la PR.
Ce qui rend cela puissant spécifiquement pour les équipes frontend : vous pouvez imposer des patterns de composants (smart vs. dumb), des limites de modules (pas d'imports cross-feature), des conventions de gestion d'état et des standards d'accessibilité — le tout comme des règles exécutables plutôt que des pages wiki que personne ne lit. Le linter reste la couche d'application. L'agent est la couche d'écriture qui suit les contraintes et se corrige. La combinaison est plus efficace que l'un ou l'autre seul.
Je pensais déjà à utiliser des agents pour l'application du linting avant de commencer mes recherches pour cet article. Maintenant je suis convaincu que c'est l'un des investissements à plus fort levier qu'une équipe frontend puisse faire. Écrivez vos règles architecturales une fois, donnez-les à vos agents et à votre pipeline CI, et arrêtez de faire les mêmes commentaires de revue de PR pour la dixième fois.
Migrations de frameworks : là où les agents surpassent déjà
S'il y a un domaine où l'IA agentique a prouvé sa valeur sans aucun doute, ce sont les migrations de frameworks. Les chiffres d'équipes réelles sont frappants. ZoomInfo a migré 938 fichiers d'Angular vers React en utilisant une flotte de 15 agents coordonnés par un agent leader. Un ingénieur, une semaine. L'estimation pour le faire manuellement : six mois avec quatre à cinq ingénieurs. mgm technology partners a migré une app SvelteKit vers Next.js avec un pipeline d'agents en quatre étapes — analyste, planificateur, implémenteur, validateur — et l'a complété en 10 jours-personnes contre 200 à 250 estimés.
L'architecture de ces migrations est importante. ZoomInfo a utilisé un agent Claude Opus comme « chef d'équipe » coordonnant 15 workers Claude Sonnet — 10 pour l'implémentation, un pour les tests unitaires, un pour les tests E2E avec Playwright, deux pour la revue de code et un pour l'audit de parité. mgm a adapté les modèles aux tâches : Opus pour la planification, Sonnet pour l'implémentation, Haiku pour la validation — réduisant les coûts d'environ 80% sur la couche de revue.
Mais les modes de défaillance sont instructifs. Les agents qui traduisent le code ligne par ligne entre frameworks produisent un résultat cassé — un reactive statement SvelteKit n'a pas d'équivalent 1:1 en React. Les équipes qui ont réussi ont traité la migration comme une reconstruction à partir d'un plan fonctionnel, pas comme une traduction. Les agents ont aussi buté sur des cas limites : fuites mémoire dans les tests async, gestion d'état sur-ingéniériée et boucles de transformation infinies. Le constat récurrent est que les agents gèrent les premiers 80% dramatiquement plus vite que les humains. Les derniers 20% — cas limites, optimisation de performance, jugement architectural — nécessitent encore des ingénieurs expérimentés.
Il y a un contrepoint intéressant de la communauté codemod : pour les patterns connus, les transformations AST déterministes sont plus fiables et moins chères que l'IA. Le talk du React Summit 2026 « Where We're Going, We Don't Need Tokens » argumente que demander à une IA de refactorer 200 fichiers brûle des tokens et hallucine parfois, alors qu'un codemod le fait parfaitement et gratuitement. L'approche pratique est d'utiliser les codemods pour les patterns connus et l'IA pour écrire des codemods personnalisés pour les patterns uniques à votre codebase.
Design-to-code : évaluation honnête
L'espace design-to-code — v0, Lovable, Bolt, screenshot-to-code — reçoit beaucoup d'attention. Voici l'évaluation honnête après avoir regardé ce que les équipes livrent réellement avec ces outils. v0 de Vercel produit les composants React + Tailwind les plus propres. C'est un spécialiste frontend, et il est vraiment bon pour générer de l'échafaudage UI qui s'intègre dans un projet Next.js existant. Lovable est l'option end-to-end la plus complète si vous voulez un MVP fonctionnel avec auth et base de données. Bolt excelle en vitesse d'itération dans son IDE navigateur.
Aucun d'entre eux ne produit du code que vous livreriez sans revue. Le résultat de v0 est le plus proche de la qualité production pour les composants UI. Lovable et Bolt produisent des apps fonctionnelles qui nécessitent du nettoyage architectural, une revue de sécurité et de l'optimisation de performance avant de toucher la production. Tous fonctionnent mieux comme accélérateurs pour les premiers 70-80% de l'implémentation — l'échafaudage qui vous amène plus vite aux décisions intéressantes.
Le changement plus grand, cependant, n'est pas dans les outils autonomes. Il est dans le workflow Figma MCP + agent de code. Quand votre agent peut lire votre vrai design system, voir vos composants existants dans Storybook et vérifier son résultat dans un vrai navigateur via DevTools MCP, le pipeline design-to-code devient contextuel plutôt que générique. C'est la direction qui m'enthousiasme le plus.
La réalité du 80/20
Dans chaque cas d'usage que j'ai recherché — revues de PR, migrations, design-to-code, application architecturale — le même pattern émerge. Les agents accélèrent les premiers 70-80% du travail frontend de manière spectaculaire. Les derniers 20-30% — cas limites, performance, accessibilité, jugement architectural — nécessitent encore l'expertise humaine. Les propres données d'Anthropic le confirment : les développeurs utilisent l'IA dans environ 60% de leur travail mais ne peuvent « pleinement déléguer » que 0-20% des tâches.
Ce n'est pas une limitation qui devrait frustrer. C'est le modèle opérationnel pour lequel il faut concevoir. Les équipes qui obtiennent les meilleurs résultats sont celles qui investissent dans des contraintes lisibles par machine — interfaces typées, règles de linting appliquées, gates CI, conventions documentées — qui guident le comportement des agents. Elles n'essaient pas de prompter leur chemin vers la qualité. Elles construisent des garde-fous qui rendent les 80% fiables et les 20% évidents.
Pour l'accessibilité spécifiquement, c'est critique. Les agents IA peuvent exécuter des vérifications WCAG et trier les violations, mais la détection automatisée ne couvre qu'environ 60-70% des problèmes d'accessibilité. Les problèmes restants — étiquetage contextuel, gestion du focus, flux du lecteur d'écran — nécessitent des tests humains. Avec l'Acte Européen d'Accessibilité en vigueur et les procès ADA aux États-Unis dépassant 4 600 par an, traiter l'accessibilité comme un problème que « l'IA va gérer » est un risque juridique, pas une stratégie.
Ce que j'essaierais ensuite
Basé sur tout ce que j'ai exploré, voici ce que je pense être le plus à fort levier pour une équipe frontend aujourd'hui. Premièrement : connectez votre agent de code à Figma MCP et Storybook MCP. Le gain immédiat est que l'agent arrête de générer des composants qui existent déjà et commence à construire sur votre vrai design system. Deuxièmement : ajoutez un reviewer de PR IA — CodeRabbit est le choix le plus sûr pour la couverture, Greptile si vous voulez une conscience architecturale plus profonde et pouvez tolérer plus de bruit.
Troisièmement — et c'est celui qui m'enthousiasme le plus : écrivez vos règles architecturales comme des contraintes exécutables. Pas une page wiki. Pas un document Confluence que personne ne lit. De vraies règles dans des fichiers CLAUDE.md ou ADR que votre agent consulte avant d'écrire du code et que votre pipeline CI applique après. Limites de composants, restrictions d'imports, patterns de gestion d'état, exigences d'accessibilité. Rendez-les lisibles par machine et vous arrêtez de compter sur la revue de code pour attraper les mêmes violations à chaque sprint.
Quatrièmement : si vous avez une migration sur la roadmap — upgrade de framework, changement de librairie, refonte du design system — lancez un pilote avec une flotte d'agents. Les résultats de ZoomInfo et mgm suggèrent qu'un pipeline d'agents bien structuré peut compresser des mois de travail de migration en jours. Le mot clé est bien structuré : vous avez besoin d'étapes claires, d'une attribution de tâches adaptée au modèle, et d'une supervision humaine sur la queue des cas limites.
Nous ne sommes pas au point où vous donnez un ticket Jira à un agent et vous partez. Mais nous sommes bien au-delà du point où les agents ne sont que de l'autocomplete. La frontière est dans le tissu conjonctif — les serveurs MCP, les règles architecturales, les intégrations CI — qui transforment des astuces IA isolées en un workflow de développement cohérent. C'est là que j'investis mon attention, et je pense que c'est là que les plus grands retours sont pour toute équipe frontend prête à expérimenter.