
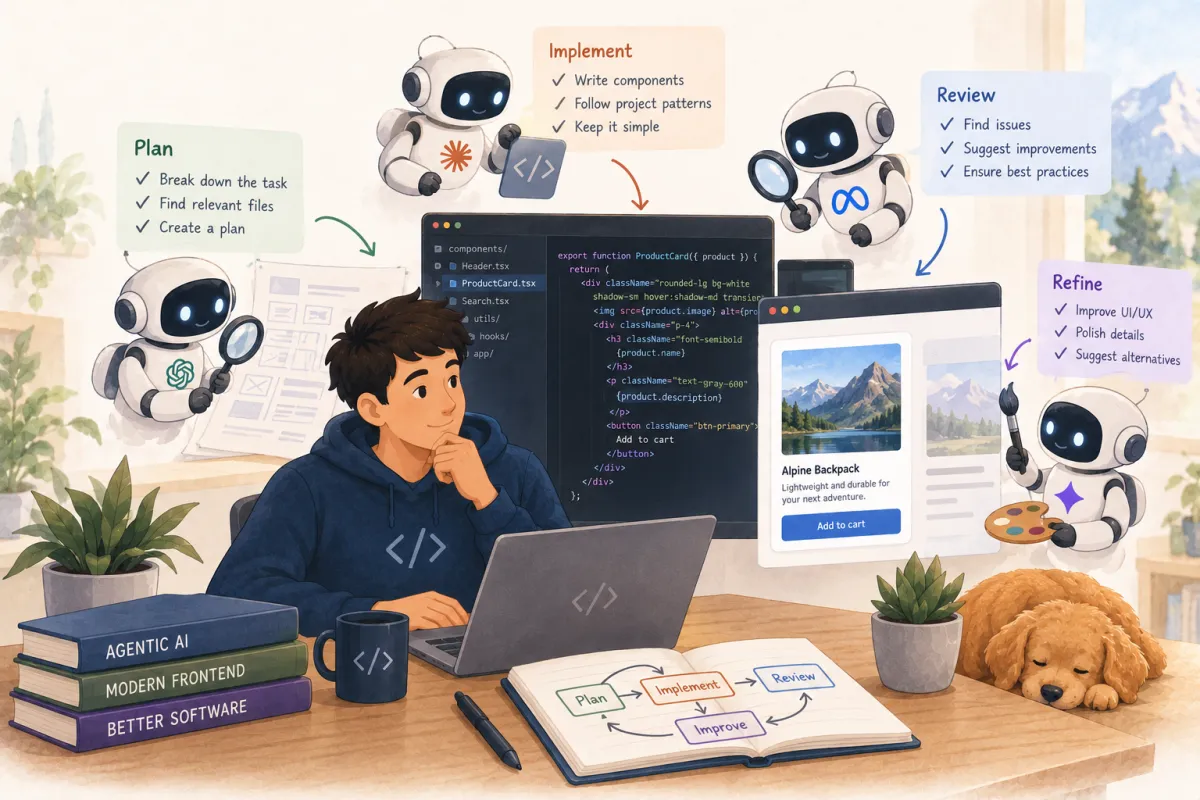
Questo post è diverso dai miei soliti scritti. Non vi guiderò attraverso qualcosa che ho consegnato. Invece, voglio esplorare cosa sta realmente accadendo con l'IA agentica nello sviluppo frontend in questo momento — quali strumenti esistono, cosa ci fanno i team, e dove penso che si trovino le vere opportunità. Consideratelo un rapporto di ricognizione.
Il mio punto di partenza era semplice: ho collegato Claude Code a un server Figma MCP. Quella singola connessione — un agente di coding IA che poteva vedere i miei file di design — ha cambiato il modo in cui penso all'intero workflow frontend. Mi ha fatto chiedere: cos'altro possono vedere gli agenti? Cos'altro possono fare? Quindi ho indagato a fondo.
Il livello MCP: dare agli agenti occhi e mani
MCP — Model Context Protocol — è il pezzo che trasforma un assistente di coding in qualcosa di più vicino a uno sviluppatore. Senza di esso, la tua IA può scrivere codice, ma è cieca. Non può vedere i tuoi design, la tua libreria di componenti, l'output del browser o i risultati dei test. Con i giusti server MCP collegati, può vedere tutto questo.
Il server Figma MCP è stato il mio punto d'ingresso. Dà all'agente accesso diretto ai dati di design — variabili, componenti, layout e persino una rappresentazione di codice React + Tailwind. Selezioni un frame in Figma, il server MCP estrae i design token e il layout, e l'agente genera componenti da un contesto di design reale invece di indovinare da uno screenshot. Sostituisce il vecchio workflow di copia-dall'inspettore. L'output non è codice di produzione — è impalcatura — ma impalcatura che usa già i tuoi veri design token e spaziature.
Ma Figma MCP è solo un pezzo. L'ecosistema che si sta formando è più interessante di qualsiasi singolo server. Storybook ha distribuito un server MCP nella versione 10.3 che permette agli agenti di consultare i tuoi componenti esistenti, le loro props e le loro storie prima di scrivere nuovo codice. Google ha lanciato Chrome DevTools MCP — gli agenti ora possono ispezionare il DOM, analizzare le richieste di rete, leggere gli errori della console e fare screenshot dell'app in esecuzione. Il Playwright MCP di Microsoft espone l'automazione del browser per i test E2E. E Context7 fornisce agli agenti la documentazione framework aggiornata, prevenendo il fallimento comune dove un agente mescola pattern di Next.js 13 e 15.
Lo stack pratico che sta emergendo: Figma MCP per il design, Storybook MCP per la tua libreria di componenti, Chrome DevTools MCP per il debugging, Playwright MCP per i test, Context7 per la documentazione framework. Collegali tutti e cinque e il tuo agente passa da un assistente di scrittura codice a qualcosa che può vedere il design, verificare cosa esiste già, generare codice, verificarlo nel browser e scrivere test. Non è un giocattolo. È un workflow.
Revisioni PR che capiscono il contesto
La revisione PR automatizzata è uno dei casi d'uso agentici più maturi nel frontend. Gli strumenti hanno superato la fase del «linter glorificato». CodeRabbit ha revisionato oltre 13 milioni di PR su 2 milioni di repository — esegue più di 40 linter integrati e genera suggerimenti contestuali per TypeScript, React e il resto del tuo stack. Greptile adotta un approccio diverso: costruisce prima un grafo di conoscenza della tua codebase, poi revisiona con contesto architetturale. Trova più bug ma genera più falsi positivi — il classico trade-off precisione-richiamo.
Cosa trovano realmente questi strumenti per i team frontend: gestione degli errori mancante, import inutilizzati, inconsistenze di tipo e anti-pattern React ovvi come array di dipendenze mancanti negli hook useEffect. Cosa non trovano in modo affidabile: problemi di performance di rendering, strategie di memoizzazione errate o bug sottili di gestione dello stato. Le valutazioni di giudizio — se questo componente debba essere diviso, se questa astrazione sia prematura, se questo flusso di dati confonderà il prossimo sviluppatore — hanno ancora bisogno di un essere umano.
Ma ecco cosa mi entusiasma: questi strumenti stanno migliorando nel comprendere le convenzioni del tuo progetto, non solo le best practice generiche. Quando il tuo reviewer IA conosce la tua codebase — la struttura delle cartelle, i pattern di nomenclatura, i confini dei componenti — può imporre la coerenza a un livello che è difficile da raggiungere per un reviewer umano su decine di PR alla settimana.
Oltre ESLint: applicare l'architettura con gli agenti
Questa è l'area che trovo più interessante per gli engineer senior e i tech lead. Il linting tradizionale trova problemi di sintassi e formattazione. L'applicazione architetturale — «niente logica di business nei componenti», «ogni chiamata API passa attraverso il layer di servizio», «lo stato condiviso deve usare questo pattern specifico» — si è sempre basata sulla revisione del codice e sulla conoscenza tribale. Questo sta cambiando.
Il pattern che sta emergendo: definisci vincoli in file leggibili dalla macchina (CLAUDE.md, AGENTS.md, Architecture Decision Records), l'agente scrive codice seguendo quelle regole, e controlli CI deterministici bloccano le violazioni. L'agente poi corregge le proprie violazioni senza intervento dello sviluppatore. Uno strumento chiamato Archgate trasforma gli ADR in file di regole eseguibili che girano in CI — un check che fallisce blocca i merge. L'agente consulta le regole prima di scrivere codice, quindi la maggior parte delle violazioni non arriva mai nella PR.
Cosa rende questo potente specificamente per i team frontend: puoi imporre pattern di componenti (smart vs. dumb), confini di modulo (niente import cross-feature), convenzioni di gestione dello stato e standard di accessibilità — il tutto come regole eseguibili anziché pagine wiki che nessuno legge. Il linter resta il livello di applicazione. L'agente è il livello di authoring che segue i vincoli e si auto-corregge. La combinazione è più efficace di ciascuno da solo.
Stavo già pensando di usare gli agenti per l'applicazione del linting prima di iniziare la ricerca per questo articolo. Ora sono convinto che sia una delle cose a più alta leva in cui un team frontend possa investire. Scrivi le tue regole architetturali una volta, dalle ai tuoi agenti e alla tua pipeline CI, e smetti di scrivere gli stessi commenti di revisione PR per la decima volta.
Migrazioni di framework: dove gli agenti già superano
Se c'è un'area in cui l'IA agentica ha dimostrato il suo valore oltre ogni dubbio, sono le migrazioni di framework. I numeri da team reali sono impressionanti. ZoomInfo ha migrato 938 file da Angular a React usando una flotta di 15 agenti coordinati da un agente leader. Un ingegnere, una settimana. La stima per farlo manualmente: sei mesi con quattro-cinque ingegneri. mgm technology partners ha migrato un'app SvelteKit a Next.js con una pipeline di agenti a quattro stadi — analista, pianificatore, implementatore, validatore — completandola in 10 giorni-persona contro i 200-250 stimati.
L'architettura di queste migrazioni è importante. ZoomInfo ha usato un agente Claude Opus come «team leader» che coordinava 15 worker Claude Sonnet — 10 per l'implementazione, uno per i test unitari, uno per i test E2E con Playwright, due per la revisione del codice e uno per l'audit di parità. mgm ha abbinato i modelli ai task: Opus per la pianificazione, Sonnet per l'implementazione, Haiku per la validazione — riducendo i costi di circa l'80% sul livello di revisione.
Ma le modalità di fallimento sono istruttive. Gli agenti che traducono codice riga per riga tra framework producono output rotto — un reactive statement di SvelteKit non ha un equivalente 1:1 in React. I team che hanno avuto successo hanno trattato la migrazione come una ricostruzione da un blueprint funzionale, non come una traduzione. Gli agenti sono anche inciampati su casi limite: memory leak nei test asincroni, gestione dello stato sovra-ingegnerizzata e loop di trasformazione infiniti. Il risultato costante è che gli agenti gestiscono il primo 80% drammaticamente più velocemente degli umani. L'ultimo 20% — casi limite, ottimizzazione delle performance, giudizio architetturale — richiede ancora ingegneri esperti.
C'è un interessante contropunto dalla comunità codemod: per i pattern noti, le trasformazioni AST deterministiche sono più affidabili e più economiche dell'IA. Il talk del React Summit 2026 «Where We're Going, We Don't Need Tokens» sostiene che chiedere a un'IA di refactorizzare 200 file brucia token e a volte allucina, mentre un codemod lo fa perfettamente e gratis. L'approccio pratico è usare i codemod per i pattern noti e l'IA per scrivere codemod personalizzati per i pattern unici della tua codebase.
Design-to-code: valutazione onesta
Lo spazio design-to-code — v0, Lovable, Bolt, screenshot-to-code — riceve molta attenzione. Ecco la valutazione onesta dopo aver guardato cosa i team effettivamente consegnano con questi strumenti. v0 di Vercel produce i componenti React + Tailwind più puliti. È uno specialista frontend, ed è genuinamente buono nel generare impalcatura UI che si inserisce in un progetto Next.js esistente. Lovable è l'opzione end-to-end più completa se vuoi un MVP funzionante con auth e database. Bolt eccelle nella velocità di iterazione nella sua IDE browser.
Nessuno di loro produce codice che consegneresti senza revisione. L'output di v0 è il più vicino alla qualità di produzione per i componenti UI. Lovable e Bolt producono app funzionali che necessitano di pulizia architetturale, revisione di sicurezza e ottimizzazione delle performance prima di toccare la produzione. Tutti funzionano meglio come acceleratori per il primo 70-80% dell'implementazione — l'impalcatura che ti porta più velocemente alle decisioni interessanti.
Il cambiamento più grande, però, non è negli strumenti standalone. È nel workflow Figma MCP + agente di coding. Quando il tuo agente può leggere il tuo vero design system, vedere i tuoi componenti esistenti in Storybook e verificare il suo output in un vero browser tramite DevTools MCP, la pipeline design-to-code diventa contestuale anziché generica. Questa è la direzione che mi entusiasma di più.
La realtà dell'80/20
In ogni caso d'uso che ho ricercato — revisioni PR, migrazioni, design-to-code, applicazione architetturale — emerge lo stesso pattern. Gli agenti accelerano il primo 70-80% del lavoro frontend in modo spettacolare. L'ultimo 20-30% — casi limite, performance, accessibilità, giudizio architetturale — richiede ancora competenza umana. I dati stessi di Anthropic lo confermano: gli sviluppatori usano l'IA in circa il 60% del loro lavoro ma possono «delegare completamente» solo lo 0-20% dei task.
Non è una limitazione di cui essere frustrati. È il modello operativo per cui progettare. I team che ottengono i migliori risultati sono quelli che investono in vincoli leggibili dalla macchina — interfacce tipizzate, regole di linting applicate, gate CI, convenzioni documentate — che guidano il comportamento degli agenti. Non stanno cercando di promptare la loro strada verso la qualità. Stanno costruendo guardrail che rendono l'80% affidabile e il 20% ovvio.
Per l'accessibilità in particolare, questo è critico. Gli agenti IA possono eseguire controlli WCAG e triagare le violazioni, ma il rilevamento automatizzato copre solo circa il 60-70% dei problemi di accessibilità. I problemi restanti — etichettatura dipendente dal contesto, gestione del focus, flusso dello screen reader — richiedono test umani. Con l'European Accessibility Act in vigore e le cause ADA negli Stati Uniti che superano le 4.600 all'anno, trattare l'accessibilità come un problema che «l'IA gestirà» è un rischio legale, non una strategia.
Cosa proverei dopo
Basandomi su tutto ciò che ho esplorato, ecco cosa penso abbia la leva più alta per un team frontend oggi. Primo: collega il tuo agente di coding a Figma MCP e Storybook MCP. Il guadagno immediato è che l'agente smette di generare componenti che esistono già e inizia a costruire sul tuo vero design system. Secondo: aggiungi un reviewer PR IA — CodeRabbit è la scelta più sicura per l'ampiezza, Greptile se vuoi una consapevolezza architetturale più profonda e puoi tollerare più rumore.
Terzo — e questo è quello che mi entusiasma di più: scrivi le tue regole architetturali come vincoli eseguibili. Non una pagina wiki. Non un documento Confluence che nessuno legge. Regole vere in file CLAUDE.md o ADR che il tuo agente consulta prima di scrivere codice e la tua pipeline CI applica dopo. Confini dei componenti, restrizioni di import, pattern di gestione dello stato, requisiti di accessibilità. Rendili leggibili dalla macchina e smetti di affidarti alla revisione del codice per trovare le stesse violazioni ogni sprint.
Quarto: se hai una migrazione sulla roadmap — upgrade di framework, cambio di libreria, rifacimento del design system — lancia un pilota con una flotta di agenti. I risultati di ZoomInfo e mgm suggeriscono che una pipeline di agenti ben strutturata può comprimere mesi di lavoro di migrazione in giorni. La parola chiave è ben strutturata: servono stadi chiari, assegnazione dei task appropriata al modello e supervisione umana sulla coda dei casi limite.
Non siamo al punto in cui dai un ticket Jira a un agente e te ne vai. Ma siamo ben oltre il punto in cui gli agenti sono solo autocomplete. La frontiera è nel tessuto connettivo — i server MCP, le regole architetturali, le integrazioni CI — che trasformano trucchi IA isolati in un workflow di sviluppo coerente. È lì che sto investendo la mia attenzione, e credo che sia lì che i ritorni più grandi sono per qualsiasi team frontend disposto a sperimentare.